Objetivos de aprendizaje
Plantear el ajuste de un modelo lineal a unas medidas como un sistema sobredeterminado y resolverlo con las ecuaciones normales .
Interpretar los residuos de un ajuste: distinguir el ruido de un modelo inadecuado.
Estimar los parámetros de un modelo de electrodo a partir de medidas de impedancia con ruido.
Reconocer cuándo un ajuste necesita pesos, un cambio de escala o un modelo mejor.
Teoría: Volumen I, Anexo B (sistemas lineales) y Anexo A (impedancia compleja) (Miguel-Medina, 2026). Tiempo: ~2 h
import sys

if "google.colab" in sys.modules:
    %pip install -q git+https://github.com/telmomm/math-tools-biomedical-electronics
import matplotlib.pyplot as plt
import numpy as np
from circuitmath.plotting import use_style
use_style()
rng = np.random.default_rng(7) # semilla fija: el cuaderno da siempre el mismo resultadoIdea clave
En los cuadernos anteriores conocías los componentes y calculabas tensiones. En el laboratorio ocurre lo contrario: mides tensiones, corrientes o impedancias y quieres saber qué componentes las explican. Es el problema inverso.
Si el modelo es lineal en los parámetros desconocidos , cada medida da una ecuación, y todas juntas forman un sistema . Pero ahora hay más ecuaciones que incógnitas y, como las medidas tienen ruido, ninguna las cumple todas. Se busca la que menos se equivoca: la que hace mínima la suma de los cuadrados de los residuos .
Esa es la solución de un sistema cuadrado, de los que ya sabes resolver, llamado de ecuaciones normales:
Primer ajuste: medir una resistencia
Para medir una resistencia se hace pasar por ella una corriente conocida y se mide la tensión. Se repite con veinte corrientes distintas. El voltímetro tiene ruido y, además, un pequeño error de cero que no conocemos. El modelo es
con dos parámetros desconocidos: y . Las «medidas» se generan aquí con valores que el ajuste no conoce.
R_REAL = 2.2e3  # ohmios   (la verdad que el ajuste no conoce)
V0_REAL = 0.15  # voltios
RUIDO_V = 0.3  # voltios, desviación típica del ruido del voltímetro

corrientes = np.linspace(0.5e-3, 10e-3, 20)
tensiones = R_REAL * corrientes + V0_REAL + RUIDO_V * rng.standard_normal(len(corrientes))

fig, ax = plt.subplots()
ax.plot(corrientes * 1e3, tensiones, "o", markersize=4)
ax.set(xlabel="Corriente (mA)", ylabel="Tensión medida (V)", title="Veinte medidas")
plt.show()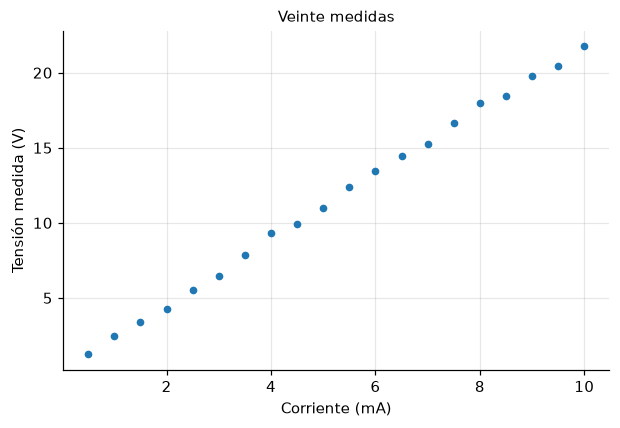
1. Predice
Hay veinte ecuaciones y dos incógnitas. ¿Existe algún par (, ) que cumpla las veinte a la vez?
Podrías calcular con solo dos medidas, la primera y la última. ¿Por qué no es buena idea?
Después del ajuste, ¿cuánto esperas que valga la suma de los veinte residuos: cero, un valor positivo o depende del ruido?
Tu predicción:
2. Ejecuta y explora
2.1 Las ecuaciones normales
Cada medida es una fila: . La matriz tiene una columna por parámetro.
A = np.column_stack([corrientes, np.ones_like(corrientes)])
b = tensiones
print("Tamaño de A:", A.shape)

x = np.linalg.solve(A.T @ A, A.T @ b)  # ecuaciones normales: un sistema de 2 x 2
R_ajuste, V0_ajuste = x
print(f"R  = {R_ajuste:.1f} Ω   (real: {R_REAL:.1f} Ω)")
print(f"V0 = {V0_ajuste:.3f} V   (real: {V0_REAL:.3f} V)")

x_numpy, *_ = np.linalg.lstsq(A, b, rcond=None)
print("¿Coincide con np.linalg.lstsq?", np.allclose(x, x_numpy))
Tamaño de A: (20, 2)
R = 2173.5 Ω (real: 2200.0 Ω)
V0 = 0.194 V (real: 0.150 V)
¿Coincide con np.linalg.lstsq? True
np.linalg.lstsq resuelve el mismo problema por otro camino, numéricamente más robusto; más abajo verás por qué importa.
Lo que el modelo no explica son los residuos. Mirarlos es la parte más importante de cualquier ajuste.
residuos = b - A @ x

fig, (ax_ajuste, ax_residuos) = plt.subplots(2, 1, sharex=True, figsize=(6.4, 5.6))
ax_ajuste.plot(corrientes * 1e3, tensiones, "o", markersize=4, label="Medidas")
ax_ajuste.plot(corrientes * 1e3, A @ x, label="Ajuste")
ax_ajuste.set(ylabel="Tensión (V)", title="Ajuste por mínimos cuadrados")
ax_ajuste.legend()
ax_residuos.stem(corrientes * 1e3, residuos, basefmt="gray")
ax_residuos.set(xlabel="Corriente (mA)", ylabel="Residuo (V)")
plt.show()

print("A^T · r =", A.T @ residuos)
print(f"Desviación típica de los residuos: {residuos.std(ddof=2):.3f} V (ruido real: {RUIDO_V} V)")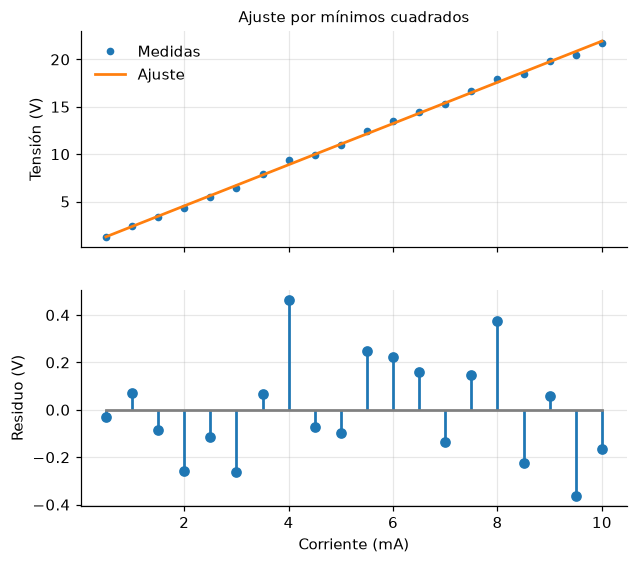
A^T · r = [2.78423118e-16 3.68594044e-14]
Desviación típica de los residuos: 0.227 V (ruido real: 0.3 V)
Tres observaciones:
Los residuos no tienen estructura: suben y bajan sin patrón. Es la firma de un modelo adecuado con medidas ruidosas.
, salvo redondeo. Eso es exactamente lo que dicen las ecuaciones normales: el residuo es perpendicular a todas las columnas de . La segunda columna es de unos, así que la suma de los residuos es cero.
La dispersión de los residuos estima el ruido del instrumento, que el ajuste tampoco conocía.
2.2 Hilo biomédico: los parámetros de un electrodo
La interfaz entre un electrodo y la piel se modela, a primera aproximación, como una resistencia en paralelo con una capacidad (cuaderno B4). No se pueden medir por separado con un polímetro: lo que se mide es la impedancia compleja del conjunto a varias frecuencias.
El modelo es lineal si se mira la admitancia :
Cada frecuencia da dos ecuaciones reales, y las incógnitas son y . Generamos treinta medidas entre 1 Hz y 10 kHz con un error aleatorio del 2 %.
RP_REAL = 50e3  # ohmios   (la verdad que el ajuste no conoce)
CP_REAL = 100e-9  # faradios


def medir(Z, ruido=0.02):
    """Añade a cada impedancia un error aleatorio relativo, en módulo y en fase."""
    n = len(Z)
    return Z * (1 + ruido * (rng.standard_normal(n) + 1j * rng.standard_normal(n)) / np.sqrt(2))


frecuencias = np.logspace(0, 4, 30)
omega = 2 * np.pi * frecuencias
Z_medida = medir(1 / (1 / RP_REAL + 1j * omega * CP_REAL))
Y = 1 / Z_medida
n = len(frecuencias)
A = np.zeros((2 * n, 2))
A[:n, 0] = 1 # n ecuaciones de la parte real: Re(Y) = Gp
A[n:, 1] = omega # n ecuaciones de la parte imaginaria: Im(Y) = ω·Cp
b = np.concatenate([Y.real, Y.imag])
(Gp, Cp), *_ = np.linalg.lstsq(A, b, rcond=None)
print(f"Rp = {1 / Gp / 1e3:.2f} kΩ (real: {RP_REAL / 1e3:.2f} kΩ)")
print(f"Cp = {Cp * 1e9:.2f} nF (real: {CP_REAL * 1e9:.2f} nF)")Rp = 42.57 kΩ (real: 50.00 kΩ)
Cp = 98.86 nF (real: 100.00 nF)
La capacidad sale con un error de alrededor del 1 %; la resistencia, con uno más de diez veces mayor. Antes de dar el resultado por malo, mira los residuos de las ecuaciones de la parte real, que son las que determinan .
residuos = b - A @ np.array([Gp, Cp])

fig, ax = plt.subplots()
ax.semilogx(frecuencias, residuos[:n] * 1e6, "o", markersize=4)
ax.axhline(Gp * 1e6, color="gray", linestyle=":", linewidth=1)
ax.axhline(-Gp * 1e6, color="gray", linestyle=":", linewidth=1)
ax.set(
    xlabel="Frecuencia (Hz)",
    ylabel="Residuo de Re(Y) (µS)",
    title="Residuos de la parte real (líneas: ± el valor de $G_p$)",
)
plt.show()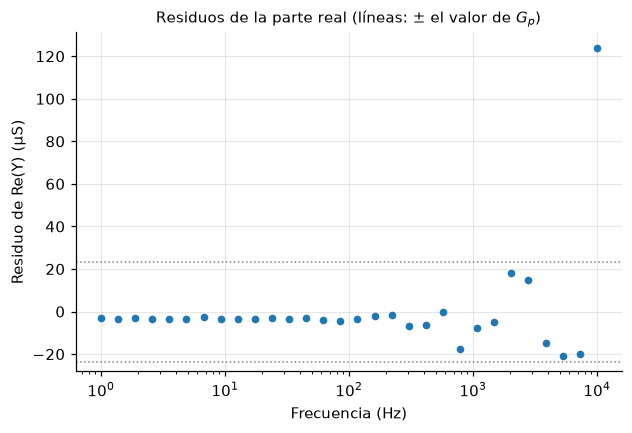
Los residuos crecen con la frecuencia hasta ser mucho mayores que el propio valor que se busca, µS. La causa: el error de medida es del 2 % de la admitancia, y a alta frecuencia la admitancia es enorme porque domina el condensador. Mínimos cuadrados da el mismo peso a todas las ecuaciones, así que unas pocas medidas muy ruidosas deciden el resultado.
El remedio es decirle al ajuste cuánto fiarse de cada ecuación: dividir cada una por el tamaño esperado de su error. Aquí el error es proporcional a , así que cada fila se multiplica por el peso .
pesos = np.concatenate([1 / np.abs(Y), 1 / np.abs(Y)])

(Gp_pesos, Cp_pesos), *_ = np.linalg.lstsq(A * pesos[:, None], b * pesos, rcond=None)
print(f"Rp = {1 / Gp_pesos / 1e3:.2f} kΩ   (real: {RP_REAL / 1e3:.2f} kΩ)")
print(f"Cp = {Cp_pesos * 1e9:.2f} nF   (real: {CP_REAL * 1e9:.2f} nF)")
Rp = 49.56 kΩ (real: 50.00 kΩ)
Cp = 100.04 nF (real: 100.00 nF)
Mínimos cuadrados minimiza exactamente lo que se le pide. Si las ecuaciones no tienen todas la misma fiabilidad, hay que decírselo.
2.3 Un modelo más realista: tres parámetros
Entre el electrodo y el amplificador hay además una resistencia en serie (el gel, el tejido). El modelo completo es
y ya no es lineal en los parámetros, ni en impedancia ni en admitancia. Pero se puede linealizar: multiplicando por y reordenando,
La impedancia medida aparece también a la derecha, multiplicando a una incógnita. No importa: es un dato. El sistema es lineal en , y , y de ellos se despejan , y . Separando parte real e imaginaria ():
RS_REAL = 500.0  # ohmios


def z_electrodo(f, Rs=RS_REAL, Rp=RP_REAL, Cp=CP_REAL, alfa=1.0):
    """Rs en serie con Rp ∥ Cp. Con alfa < 1 es el modelo de Cole (apartado 2.5)."""
    return Rs + Rp / (1 + (2j * np.pi * f * Rp * Cp) ** alfa)


def sistema_electrodo(f, Z):
    """Matriz A y vector b del ajuste linealizado de (a, b, c)."""
    omega = 2 * np.pi * f
    n = len(f)
    A = np.zeros((2 * n, 3))
    A[:n, 0] = 1
    A[:n, 2] = omega * Z.imag
    A[n:, 1] = omega
    A[n:, 2] = -omega * Z.real
    return A, np.concatenate([Z.real, Z.imag])


frecuencias = np.logspace(0, 5, 40)  # de 1 Hz a 100 kHz
Z_medida = medir(z_electrodo(frecuencias))
A, b = sistema_electrodo(frecuencias, Z_medida)
Antes de resolver, una comprobación heredada del cuaderno B5: el número de condición.
print(f"Número de condición de A:      {np.linalg.cond(A):.1e}")
print(f"Número de condición de A^T·A:  {np.linalg.cond(A.T @ A):.1e}")
print(f"Inverso de la precisión de la máquina: {1 / np.finfo(float).eps:.1e}")

escala = np.linalg.norm(A, axis=0)  # tamaño de cada columna
A_escalada = A / escala
print(f"\nTamaño de las columnas: {escala}")
print(f"Número de condición de A escalada:     {np.linalg.cond(A_escalada):.1f}")
Número de condición de A: 1.3e+08
Número de condición de A^T·A: 1.8e+16
Inverso de la precisión de la máquina: 4.5e+15
Tamaño de las columnas: [6.32455532e+00 9.40940414e+05 4.74721625e+08]
Número de condición de A escalada: 31.1
Las ecuaciones normales elevan al cuadrado el número de condición: . Aquí el resultado roza el límite de la doble precisión, donde ya no queda ninguna cifra fiable. Por eso las bibliotecas numéricas no resuelven las ecuaciones normales, sino que trabajan directamente con .
El mal condicionamiento viene de las unidades: una columna vale 1, otra es del orden de 105 y la tercera, de 109. Dividir cada columna por su tamaño (equivale a cambiar las unidades de las incógnitas) lo arregla sin cambiar el problema. La función de ajuste hace las dos cosas: escala y usa lstsq.
def ajustar_electrodo(f, Z):
    """Estima Rs, Rp y Cp por mínimos cuadrados a partir de medidas de impedancia."""
    A, b = sistema_electrodo(f, Z)
    escala = np.linalg.norm(A, axis=0)
    solucion, *_ = np.linalg.lstsq(A / escala, b, rcond=None)
    a, b_, c = solucion / escala
    Rs = b_ / c
    Rp = a - Rs
    return Rs, Rp, c / Rp


Rs, Rp, Cp = ajustar_electrodo(frecuencias, Z_medida)
print(f"Rs = {Rs:.1f} Ω     (real: {RS_REAL:.1f} Ω)")
print(f"Rp = {Rp / 1e3:.2f} kΩ   (real: {RP_REAL / 1e3:.2f} kΩ)")
print(f"Cp = {Cp * 1e9:.2f} nF   (real: {CP_REAL * 1e9:.2f} nF)")
Rs = 501.2 Ω (real: 500.0 Ω)
Rp = 47.52 kΩ (real: 50.00 kΩ)
Cp = 96.71 nF (real: 100.00 nF)
sale muy bien; y quedan algo por debajo de su valor real. Si es casualidad o no, lo verás en el apartado 2.4.
La forma habitual de representar una impedancia en bioimpedancia es el diagrama de Nyquist: la parte imaginaria cambiada de signo frente a la parte real, con un punto por frecuencia. Una resistencia en paralelo con un condensador dibuja un semicírculo; la resistencia en serie lo desplaza hacia la derecha.
def nyquist(ax, Z, *args, **kwargs):
    ax.plot(Z.real / 1e3, -Z.imag / 1e3, *args, **kwargs)
    ax.set(xlabel="Re(Z) (kΩ)", ylabel="−Im(Z) (kΩ)")
    ax.set_aspect("equal")


f_fino = np.logspace(0, 5, 300)

fig, ax = plt.subplots()
nyquist(ax, Z_medida, "o", markersize=4, label="Medidas")
nyquist(ax, z_electrodo(f_fino, Rs, Rp, Cp), label="Modelo ajustado")
ax.set_title("Impedancia del electrodo")
ax.legend()
plt.show()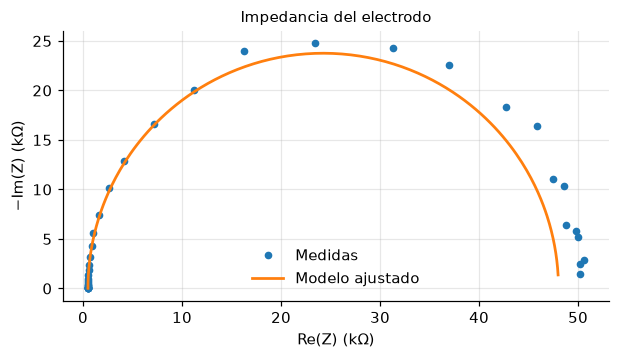
2.4 ¿Cuánto me puedo fiar del resultado?
Un ajuste da un número, no su incertidumbre. La herramienta de B5 la proporciona: repetimos el experimento quinientas veces, cada una con un ruido distinto, y miramos cómo se reparten las estimaciones.
REPETICIONES = 500

fig, ax = plt.subplots()
for ruido in (0.01, 0.02):
    estimaciones = np.array(
        [
            ajustar_electrodo(frecuencias, medir(z_electrodo(frecuencias), ruido))
            for _ in range(REPETICIONES)
        ]
    )
    Rp_estimada = estimaciones[:, 1]
    ax.hist(Rp_estimada / 1e3, bins=30, alpha=0.6, label=f"Ruido del {ruido:.0%}")
    print(
        f"Ruido {ruido:.0%}: Rp = {Rp_estimada.mean() / 1e3:.2f} ± {Rp_estimada.std() / 1e3:.2f} kΩ"
        f"   (real: {RP_REAL / 1e3:.2f} kΩ)"
    )
ax.axvline(RP_REAL / 1e3, color="k", linestyle="--", linewidth=1, label="Valor real")
ax.set(xlabel="$R_p$ estimada (kΩ)", ylabel="Número de ajustes", title="Quinientos ajustes")
ax.legend()
plt.show()
Ruido 1%: Rp = 49.25 ± 0.40 kΩ (real: 50.00 kΩ)
Ruido 2%: Rp = 47.32 ± 1.30 kΩ (real: 50.00 kΩ)
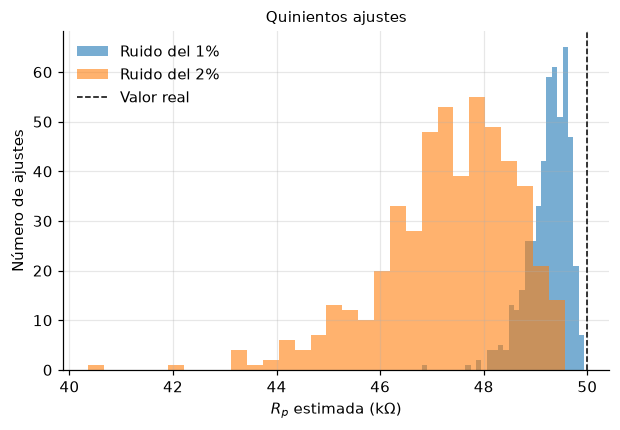
Las estimaciones no solo se dispersan: se agrupan por debajo del valor real, y más cuanto mayor es el ruido. El estimador está sesgado. Es el precio del truco de la linealización: la impedancia medida, con su ruido, está también dentro de la matriz , y mínimos cuadrados supone que el ruido solo está en .
Medir más frecuencias reduce la dispersión, pero no el sesgo. Por eso el ajuste lineal se usa a menudo como punto de partida de un ajuste no lineal, que trabaja con el modelo sin transformar.
2.5 Cuando el modelo no es el adecuado
Los tejidos y los electrodos reales no dibujan un semicírculo perfecto, sino un arco achatado. El modelo de Cole Cole & Cole, 1941 lo describe con un parámetro más, :
Con es exactamente nuestro modelo (, ). Generamos medidas con y con muy poco ruido, y las ajustamos con el modelo de tres parámetros, que supone .
Z_cole = medir(z_electrodo(frecuencias, alfa=0.8), ruido=0.002)
Rs_c, Rp_c, Cp_c = ajustar_electrodo(frecuencias, Z_cole)
Z_ajuste = z_electrodo(frecuencias, Rs_c, Rp_c, Cp_c)

fig, (ax_nyquist, ax_residuos) = plt.subplots(1, 2, figsize=(9, 3.8))
nyquist(ax_nyquist, Z_cole, "o", markersize=4, label="Medidas (α = 0,8)")
nyquist(ax_nyquist, z_electrodo(f_fino, Rs_c, Rp_c, Cp_c), label="Ajuste con α = 1")
ax_nyquist.legend(loc="lower center", bbox_to_anchor=(0.5, 1.02), ncol=2, fontsize="small")
ax_residuos.semilogx(frecuencias, (Z_cole - Z_ajuste).real / 1e3, "o-", markersize=4, label="Real")
ax_residuos.semilogx(frecuencias, (Z_cole - Z_ajuste).imag / 1e3, "s-", markersize=4, label="Imag.")
ax_residuos.set(xlabel="Frecuencia (Hz)", ylabel="Residuo (kΩ)", title="Residuos")
ax_residuos.legend()
fig.tight_layout()
plt.show()

print(f"Rp ajustada: {Rp_c / 1e3:.1f} kΩ (real: {RP_REAL / 1e3:.1f} kΩ)")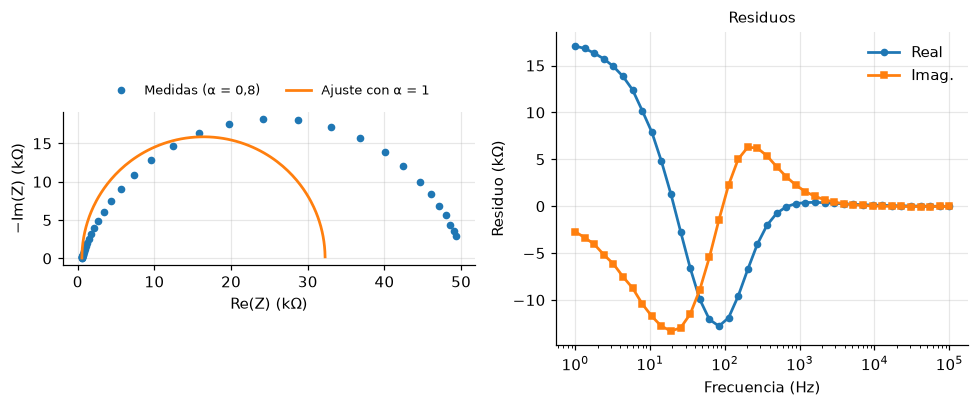
Rp ajustada: 31.7 kΩ (real: 50.0 kΩ)
Compara estos residuos con los del apartado 2.1. Aquí tienen estructura: describen una curva suave y cambian de signo de forma ordenada. No es ruido: es la parte de las medidas que el modelo no puede reproducir. Ningún número de medidas adicionales lo arreglaría; hace falta un modelo mejor.
Leer los residuos es la manera de distinguir los dos problemas: residuos sin estructura indican ruido; residuos con estructura, un modelo inadecuado. El modelo de Cole no es lineal en , así que ajustarlo requiere mínimos cuadrados no lineales, que es el reto de los ejercicios.
3. Explica
En las ecuaciones normales, . ¿Qué significa geométricamente? ¿Por qué garantiza que la suma de los residuos del primer ajuste sea cero?
En el apartado 2.2, antes de usar pesos, salía bien y no. ¿Por qué el mismo ruido afecta tan distinto a los dos parámetros?
Cada parámetro del modelo de tres elementos se «ve» en una zona de frecuencias. ¿Dónde se ve , dónde y dónde ? Repite el ajuste midiendo solo hasta 1 kHz y explica qué parámetro empeora.
Escalar las columnas de reduce el número de condición de 108 a unas decenas sin cambiar la solución. ¿Qué relación tiene con el circuito mal condicionado del cuaderno B5?
El histograma del apartado 2.4 muestra dispersión y sesgo. ¿Cuál de los dos se reduce promediando muchas medidas? ¿Cuál no, y por qué?
Un compañero ajusta unas medidas reales de bioimpedancia con el modelo de tres parámetros y obtiene residuos pequeños pero en forma de onda. ¿Qué le dirías?
4. Ejercicios
Básico. Ajusta las medidas del primer apartado con el modelo , sin error de cero. Ahora tiene una sola columna: escribe a mano la solución de las ecuaciones normales y comprueba que coincide con la de
lstsq. ¿Cómo cambian y los residuos? ¿Siguen sumando cero?Aplicación. La curva de calibración de un sensor se ajusta a menudo con un polinomio. Genera veinte puntos de con entre 0 y 10 y un poco de ruido, y ajústalos con polinomios de grado 2, 5 y 10 construyendo tú la matriz (columnas ).
Calcula el número de condición de y de en cada caso.
Compara la solución de las ecuaciones normales con la de
lstsq. ¿A partir de qué grado dejan de coincidir?Repite con reescalado al intervalo . ¿Qué cambia?
Reto biomédico. Ajusta el modelo de Cole completo a las medidas
Z_cole.Escribe una función que devuelva el vector de residuos (parte real y parte imaginaria) para unos parámetros .
Minimízala con
scipy.optimize.least_squares, usando como punto de partida el resultado del ajuste lineal y .Compara los parámetros con los reales y representa los nuevos residuos. ¿Tienen estructura?
La bioimpedancia se usa para estimar la composición corporal: se relaciona con el agua extracelular y , con el agua total. ¿Por qué interesa extrapolar esos dos valores con un modelo en lugar de medirlos directamente a frecuencia cero y a frecuencia infinita?
Resumen
Más medidas que incógnitas y ruido: no hay solución exacta. Mínimos cuadrados elige la que minimiza , y cumple .
Las ecuaciones normales elevan al cuadrado el número de condición: en la práctica se escalan las columnas y se usa
np.linalg.lstsq.Si las ecuaciones no son igual de fiables, hay que ponderarlas; si el ruido está también dentro de , el resultado está sesgado.
Los residuos son el diagnóstico: sin estructura, ruido; con estructura, un modelo inadecuado.
Con este cuaderno termina el Bloque B. Has recorrido el camino completo: del circuito a la matriz, de la matriz al simulador, y de las medidas de vuelta al modelo.
- Miguel-Medina, T. (2026). Electrónica en Ingeniería Biomédica — Volumen I. Autopublicación. 10.5281/zenodo.22913382
- Cole, K. S., & Cole, R. H. (1941). Dispersion and absorption in dielectrics I. Alternating current characteristics. The Journal of Chemical Physics, 9(4), 341–351. 10.1063/1.1750906